Un pipeline de OCR + LLM listo para producción separa tres trabajos: el OCR lee los píxeles, el LLM convierte texto desordenado en campos estructurados y el código decide. Usé esa división en una promoción que manejó un pool fijo de 80,000 folios y verificó comprobantes de compra con Tesseract y LLaMA 3.3 70B, sin revisión manual, cada 2 minutos.
Este artículo trata de arquitectura y escala. El lado de Python está en Automatización con Python para OCR + LLM y Optimización de Python para 80,000 folios, y el de WordPress en Optimizar WordPress para OCR + LLM en producción.
Arquitectura de microservicios para OCR + LLM
Pipeline de OCR + LLM: un flujo de documentos donde el OCR extrae el texto, un LLM lo estructura y reglas deterministas lo aprueban o lo rechazan.
El orden importa más que los modelos. El OCR es barato y tonto. El LLM es listo y no determinista. Las reglas son aburridas y auditables. Cada pieza hace solo lo que hace bien.
Un artículo reciente sobre cómo operar esto en producción, Operationalizing Document AI (arXiv:2605.18818), divide el sistema en microservicios que se despliegan por separado en Kubernetes, con colas de mensajes que reparten el trabajo. Dos de sus hallazgos coinciden con lo que vi en un sistema mucho más chico:
- En su perfilado por lotes, el OCR, no el modelo de lenguaje, dominó la latencia de punta a punta.
- La concurrencia la limitó la capacidad compartida de inferencia, no el número de workers.
La consecuencia: escala el OCR y la inferencia por separado, y pon una cola entre los dos. Este es el worker que desplegaría para cada documento. Es un ejemplo simplificado, no el archivo de producción:
def process(job):
    # Idempotencia: la llave del trabajo es el hash del comprobante, así que un
    # reintento después de una caída nunca crea un segundo veredicto para la misma imagen.
    if verdicts.exists(job.sha256):
        return
    text = pytesseract.image_to_string(preprocess(job.image), lang="spa")
    # El modelo solo propone campos estructurados. Nunca aprueba nada.
    fields = llm.extract(text, schema=RECEIPT_SCHEMA, temperature=0)
    # Las reglas de negocio viven en código: se prueban, se versionan y se auditan.
    ok, reason = rules.validate(fields, promo=job.promo)
    status = "approved" if ok else ("review" if reason.uncertain else "rejected")
    verdicts.save(job.sha256, status, reason, fields)
Tres estados, no dos. «Revisión» es la válvula de escape: lo que las reglas no pueden resolver va a una persona en lugar de adivinarse.
Cargas de trabajo a escala empresarial
El throughput es cuántos documentos terminan por minuto. El cuello de botella es la etapa más lenta, y en pipelines de OCR + LLM casi nunca es el ciclo de Python.
En el sistema real, todo el pipeline corría por cron cada 2 minutos en un VPS con AlmaLinux. La regla que lo mantuvo estable: un lote lento nunca debe encimarse con el siguiente. flock lo resuelve en una línea.
⚠️ Esto toca un servidor en producción. Respalda el crontab (
crontab -l > crontab.bak) antes de editarlo y deja la línea vieja comentada para revertir en segundos.
# /etc/cron.d/receipt-verifier — cada 2 minutos, nunca dos corridas a la vez.
# flock -n sale de inmediato si la corrida anterior todavía tiene el candado:
# una respuesta lenta del LLM retrasa UN lote en lugar de duplicar la carga.
# timeout mata una corrida colgada antes del siguiente turno: el candado siempre se libera.
*/2 * * * * www-data flock -n /var/lock/receipt-verifier.lock \
  timeout 110 /usr/bin/php /var/www/tools/verify.php \
  >> /var/log/receipt-verifier.log 2>&1
# Reversión: comenta la línea de arriba y corre el script anterior a mano una vez
# para terminar lo que haya quedado a medias (el worker es idempotente).
Cuando un VPS ya no alcanza, separo el OCR y las llamadas al LLM en contenedores distintos, cada uno con su propio límite de memoria, para que el OOM killer tumbe un worker y no el sitio:
# docker-compose.yml — el OCR y el LLM escalan por separado.
services:
  ocr-worker:
    image: verifier-ocr:1.0
    deploy: { replicas: 4, resources: { limits: { memory: 1g } } }  # Tesseract consume mucha RAM con imágenes grandes
    environment: [QUEUE_URL=redis://queue:6379/0]
  llm-worker:
    image: verifier-llm:1.0
    deploy: { replicas: 2 }        # lo limita el rate limit del proveedor, no el CPU
    environment: [QUEUE_URL=redis://queue:6379/1, LLM_TIMEOUT=20]
  queue:
    image: redis:7
¿Por qué dos réplicas para el LLM y cuatro para el OCR? Porque el proveedor de inferencia pone el techo. Agregar workers de LLM por encima del rate limit solo agrega reintentos.
Caso: un pool de 80,000 folios
Para Panini Fan Zone FWC 2026, como parte del equipo de Conqr Digital Agency, escribí dos plugins propios de WordPress en PHP. Emitían y controlaban un pool fijo de 80,000 folios con un QR por registro, y verificaban los comprobantes de compra con Tesseract OCR seguido de LLaMA 3.3 70B en Groq. Corría solo, sin que nadie revisara los comprobantes uno por uno.
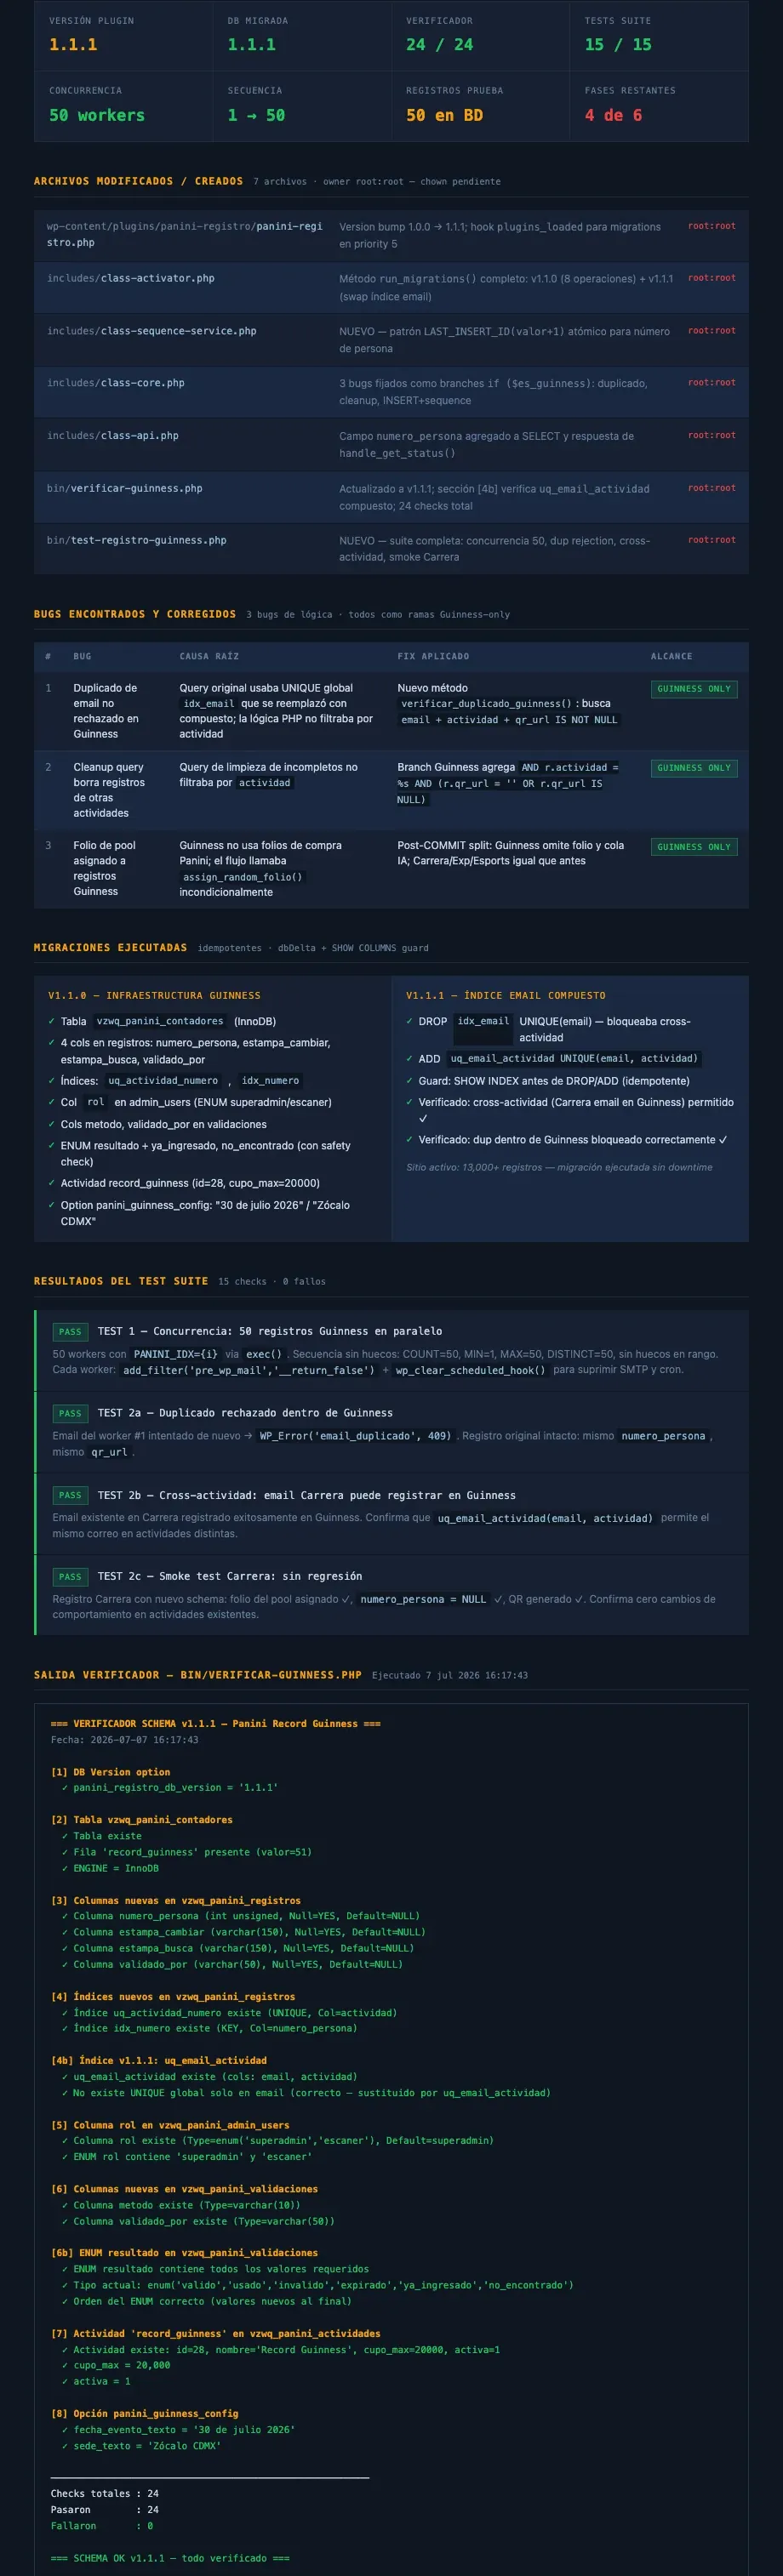
El bug más difícil no estuvo en la IA. El registro del intento de récord necesitaba «una persona, un registro, por actividad». El primer índice de unicidad validaba el correo de forma global, así que el mismo correo podía registrarse dos veces en actividades distintas. El arreglo fue un índice único compuesto, con una validación que revisa el esquema antes de alterarlo. El plugin pasó de v1.1.0 a v1.1.1.
⚠️ Cambios de esquema en producción: saca primero un respaldo de la base (
mysqldump --single-transaction) y corre la migración en una ventana de poco tráfico. Revertir es restaurar ese respaldo.
// Unicidad por actividad: mismo correo + otra actividad = válido;
// mismo correo + misma actividad = lo rechaza MySQL, incluso en una carrera.
global $wpdb;
$table = $wpdb->prefix . 'record_registrations';
// Validación: primero lee el esquema actual, para que la migración sea
// idempotente y se pueda volver a correr en cada actualización del plugin.
$has = $wpdb->get_var("SHOW INDEX FROM $table WHERE Key_name = 'uniq_email_activity'");
if (!$has) {
    $wpdb->query("ALTER TABLE $table DROP INDEX uniq_email");
    $wpdb->query("ALTER TABLE $table ADD UNIQUE KEY uniq_email_activity (email, activity_id)");
}
Un buen índice sigue siendo una hipótesis hasta que aguanta carga. Antes de entregar, un verificador independiente y una suite de 15 pruebas incluyeron una prueba de concurrencia: 50 workers simultáneos contra la misma ruta de registro. Hubo exactamente un registro exitoso por cupo, con cero errores de servidor. El módulo pasó 24 de 24 verificaciones y 15 de 15 pruebas.
El error que más veo en la industria: correr el OCR y la llamada al LLM dentro de la misma petición web que recibe el archivo. En la demo funciona. En una campaña real, cada llamada lenta de inferencia retiene un worker de PHP, el pool se llena y el sitio se cae para todos, incluso para quien solo estaba navegando. Recibe el archivo, mételo a la cola, responde «recibido» y procésalo aparte.
Lo que NO haría
No dejo que el LLM apruebe o rechace nada. Un modelo de lenguaje puede equivocarse con total seguridad, y «el modelo lo dijo» no es una pista de auditoría. El modelo extrae, las reglas escritas en código deciden y lo dudoso va a una persona.
No empiezo con Kubernetes para una sola campaña. Un cron con flock en un VPS manejó un pool de 80,000 folios. Separo en servicios cuando el OCR y la inferencia de verdad necesitan escalar por separado, no antes, porque cada pieza extra es una cosa más que vigilar a las 3 de la mañana.
Siguiente paso
¿Tienes un flujo de documentos que todavía depende de alguien leyendo comprobantes a mano? Mándame una muestra anonimizada y las reglas que tiene que cumplir. Te digo qué parte le toca al OCR, cuál a un LLM y cuál debe quedarse como regla en código. Escríbeme. Cotiza por WhatsApp en 2 min